
PostgreSQL-Cluster: Hochverfügbarkeit ist noch kein Backup
Wer PostgreSQL hochverfügbar betreiben möchte, muss zwei unterschiedliche Fragen beantworten: Wie bleibt die Datenbank beim Ausfall eines Knotens erreichbar und wie kommen die Daten nach einem Bedienfehler, einer logischen Beschädigung oder einem größeren Infrastrukturverlust zurück?
Der folgende Aufbau ist eine allgemeine Zielarchitektur. Dimensionierung, Replikationsmodus, Aufbewahrungsdauer und Wiederanlaufziele müssen immer aus dem tatsächlichen Workload sowie den vereinbarten RPO- und RTO-Werten abgeleitet werden.
Drei verschiedene Probleme, drei verschiedene Antworten
| Ereignis | Zuständige Ebene | Was sie leisten soll |
|---|---|---|
| PostgreSQL-Prozess oder VM fällt aus | Patroni, Replikation, Routing | Einen geeigneten Standby zum Primary machen und Verbindungen neu aufbauen |
Fehlendes DELETE, kaputte Migration oder logische Korruption |
pgBackRest und WAL-Archiv | Datenstand vor dem Fehler auf einer separaten Instanz wiederherstellen |
| Standort, Storage oder Backup-Ziel fällt aus | Räumlich getrennte Kopie und Restore-Verfahren | Wiederherstellung auch ohne die ursprüngliche Plattform ermöglichen |
Replikation kopiert auch versehentlich gelöschte Daten. Ein zweiter PostgreSQL-Knoten löst deshalb kein Restore-Problem. Ebenso ersetzt ein Backup keinen automatischen Rollenwechsel im Fehlerfall.
Zugriffspfade
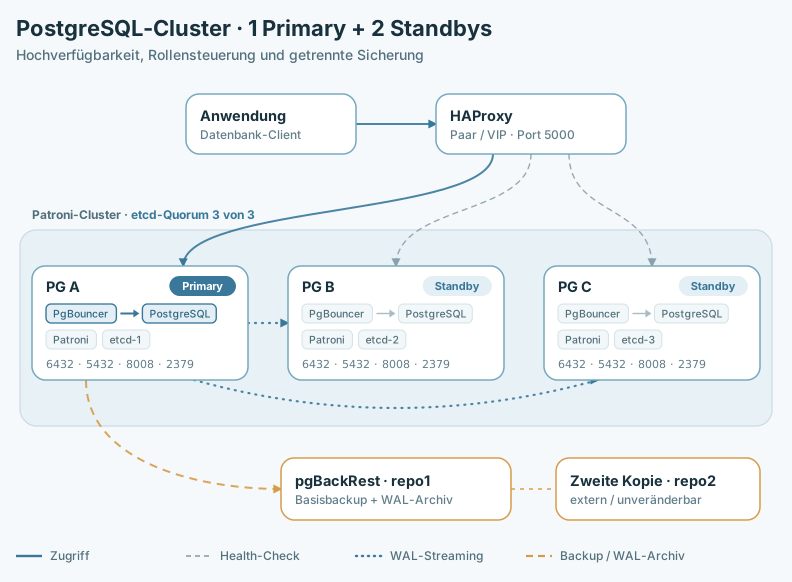
Die Anwendung bekommt einen stabilen Endpunkt: HAProxy. HAProxy prüft über die Patroni-REST-API, welcher Knoten aktuell Primary ist, und leitet Verbindungen ausschließlich an den PgBouncer auf genau diesem Knoten. Dieser PgBouncer poolt nur zum lokalen PostgreSQL. Im Zielbild besteht der Datenbank-Cluster aus drei Knoten: einem Primary und zwei Standbys auf jedem laufen PgBouncer, PostgreSQL, Patroni und ein Mitglied des etcd-Clusters. Zwei HAProxy-Instanzen beziehungsweise ein abgesicherter virtueller Endpunkt vermeiden, dass der Proxy selbst zum einzigen Ausfallpunkt wird.
Die genaue Reihenfolge von PgBouncer und HAProxy kann je nach Deployment variieren. Entscheidend ist, dass jeder Verbindungsaufbau den aktuellen Primary erreicht, der Pool nach einem Failover tote Sessions verwirft und die Anwendung fehlgeschlagene Transaktionen kontrolliert erneut versucht. Zu prüfen sind insbesondere Transaktionsverhalten, Prepared Statements und die gewählte Pooling-Art. Ein Failover ist für eine bereits laufende Transaktion kein transparenter Erfolg.
Warum nicht umgekehrt, also ein zentraler PgBouncer vor HAProxy? Ein zentraler Pool hält seine Backend-Verbindungen über HAProxy offen. Nach einem Patroni-Failover zeigen diese Verbindungen noch auf den alten Primary und müssen erst erkannt und verworfen werden. Mit einem lokalen PgBouncer pro Knoten hängen die Backend-Verbindungen am Knoten, nicht an der Rolle: Beim Umschalten wechselt HAProxy einfach den kompletten Zielknoten, und kein Pool zeigt mehr auf den alten Primary. Damit verbliebene Client-Sessions zum alten Knoten nicht weiterlaufen, trennt HAProxy sie beim Markieren als „down“:
backend pg_primary
  option httpchk GET /primary
  http-check expect status 200
  default-server port 8008 on-marked-down shutdown-sessions
  server pg-a pg-a:6432 check
  server pg-b pg-b:6432 check
  server pg-c pg-c:6432 check
Der Health-Check fragt Patroni auf Port 8008, die Verbindung selbst geht an PgBouncer auf Port 6432 desselben Knotens. Für Lesezugriffe kann ein zweites Backend mit /replica die PgBouncer der Standbys ansprechen. Zu prüfen bleiben Transaktionsverhalten, Prepared Statements und die gewählte Pooling-Art. Ein Failover ist für eine bereits laufende Transaktion kein transparenter Erfolg – die Anwendung muss Verbindungen neu aufbauen und fehlgeschlagene Transaktionen kontrolliert wiederholen.
Asynchrone Replikation kann beim Failover kürzlich bestätigte Transaktionen verlieren. Synchrone Replikation reduziert dieses Risiko, koppelt Schreibverfügbarkeit aber an erreichbare synchrone Standbys; selbst sie ist keine pauschale Garantie für null Datenverlust in jedem Mehrfachfehler. Bei drei Datenknoten kann Patroni nach dem Ausfall des Primary einen geeigneten Standby promoten, während der andere Standby weiterhin als Replikat zur Verfügung steht beziehungsweise dem neuen Primary folgt. Da auch etcd auf diesen Nodes läuft, bleiben nach dem Ausfall eines Nodes zwei von drei etcd-Mitgliedern und damit das Quorum erhalten. Bei zwei ausgefallenen Nodes gibt es bewusst kein Quorum und damit keine sichere automatische Leader-Wahl. RPO und Schreibverfügbarkeit bleiben trotzdem eine bewusste Entscheidung, keine Patroni-Voreinstellung.
Backup
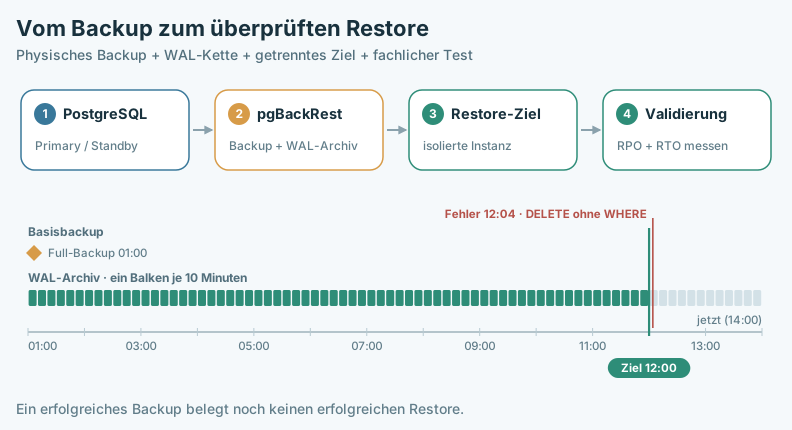
Für die physische Sicherung plane ich pgBackRest mit vollständigen und gegebenenfalls differentiellen oder inkrementellen Backups. Zusätzlich archiviert PostgreSQL abgeschlossene WAL-Segmente. Erst Basisbackup plus passende WAL-Kette erlauben Point-in-Time-Recovery (PITR). Das Repository sollte außerhalb des Daten-Clusters liegen, mit separaten Berechtigungen, Retention und idealerweise einer zusätzlichen standortgetrennten oder unveränderbaren Kopie.
Ein bewusst verkürztes Konfigurationsmuster für einen einzelnen Cluster sieht so aus; Pfade, Benutzer, Repository-Typ, TLS/SSH und Retention müssen zur tatsächlichen Umgebung passen:
# PostgreSQL-Parameter (Beispielwerte; mit Patroni zentral verwalten)
wal_level = replica
archive_mode = on
archive_command = 'pgbackrest --stanza=main archive-push %p'

# pgbackrest.conf (Beispiel für lokales Repository; produktiv getrennt betreiben)
[global]
repo1-path=/backup/pgbackrest
repo1-retention-full=2

[main]
pg1-path=/var/lib/postgresql/18/main
Die Aufbewahrung von zwei Full-Backups ist hier lediglich ein Syntaxbeispiel, keine allgemeine Empfehlung für RPO- oder Ransomware-Anforderungen. Eine echte Konfiguration braucht außerdem Zugriffsschutz, Monitoring, Kapazitätsplanung und einen festgelegten Zeitplan. Ein typischer Prüfablauf:
pgbackrest --stanza=main stanza-create
pgbackrest --stanza=main check
pgbackrest --stanza=main --type=full backup
pgbackrest --stanza=main info
check testet die Konfiguration und WAL-Archivierung. Es beweist keinen erfolgreichen Restore. Für den Wiederanlauf muss ein isoliertes Ziel mit passender PostgreSQL-Hauptversion bereitstehen. pgBackRest kann auf einen Zeitpunkt vor einer schädlichen Änderung zurückspielen; den exakten Recovery-Zeitpunkt lege ich anhand von Ereignisprotokollen und Anwendungsdaten fest.
# Nur auf einem eigens vorbereiteten, gestoppten Restore-Ziel ausführen.
# Die Datenverzeichnis- und Cluster-Vorgaben vorher separat prüfen.
pgbackrest --stanza=main \
  --type=time \
  --target='2026-09-29 12:00:00+02' \
  --target-action=promote \
  restore
Bei --type=time gilt: Zeitzone und Ereigniszeit sauber verifizieren. restore schreibt in das konfigurierte PostgreSQL-Datenverzeichnis; deshalb niemals beiläufig auf dem produktiven Primary ausführen. Danach PostgreSQL starten, Recovery abschließen lassen und Datenkonsistenz sowie zentrale Anwendungsfunktionen prüfen.
RTO und RPO
Ein formuliertes RTO ist zunächst eine Anforderung, kein nachgewiesener Wert. Für ein physisches Backup zählen Repository-Durchsatz, Datenmenge, WAL-Volumen, Recovery-Dauer, DNS- und Connection-Handling sowie die Validierung der Anwendung. Deshalb sollten regelmäßig diese Übungen protokolliert werden:
- Knotenausfall: Primary stoppen, Promotion, neues Routing und Verhalten laufender Schreibtransaktionen messen.
- PITR: Ein definiertes Testereignis erzeugen, vor den Fehler zurückspielen und Zeilen/Anwendungsfunktionen prüfen.
- Repository-Ausfall: Restore aus der zweiten Kopie in eine frische Umgebung erproben.
- WAL-Lücke: Alarmierung testen; ein vorhandenes Full-Backup ohne lückenlose WAL-Kette erreicht den gewünschten Zeitpunkt nicht.
Monitoring braucht dafür mindestens: Replikationsverzug in Bytes und Zeit, DCS-Quorum, Patroni-Rolle, HAProxy-Health, PgBouncer-Auslastung, letzte erfolgreiche Sicherung, Alter des letzten archivierten WAL-Segments, Repository-Füllstand und Dauer des letzten Restore-Tests. Backups ohne Restore-Messung liefern nur ein gutes Gefühl.
Der Cluster löst keine Schema- oder Abfrageprobleme
Hochverfügbarkeit ersetzt keine Datenbankpflege. Vor dem produktiven Clusterbetrieb gehören Schema und Indexe, VACUUM/ANALYZE, Abfragepläne, Connection Pooling und das Transaktionsverhalten der Anwendung auf die Prüfliste. Ein Standby repliziert auch ineffiziente Strukturen und teure Abfragen.
Mein Fazit: Der Cluster soll die Anwendung nach einem Knotenausfall wieder erreichbar machen. pgBackRest, WAL-Archivierung und ein geübter Restore sollen die Daten nach einem inhaltlichen oder technischen Schaden zurückholen. Ob das definierte RTO tatsächlich erreichbar ist, entscheidet erst die Stoppuhr beim vollständigen Wiederanlauf.